Belajar Python Web Scraping BeautifulSoup
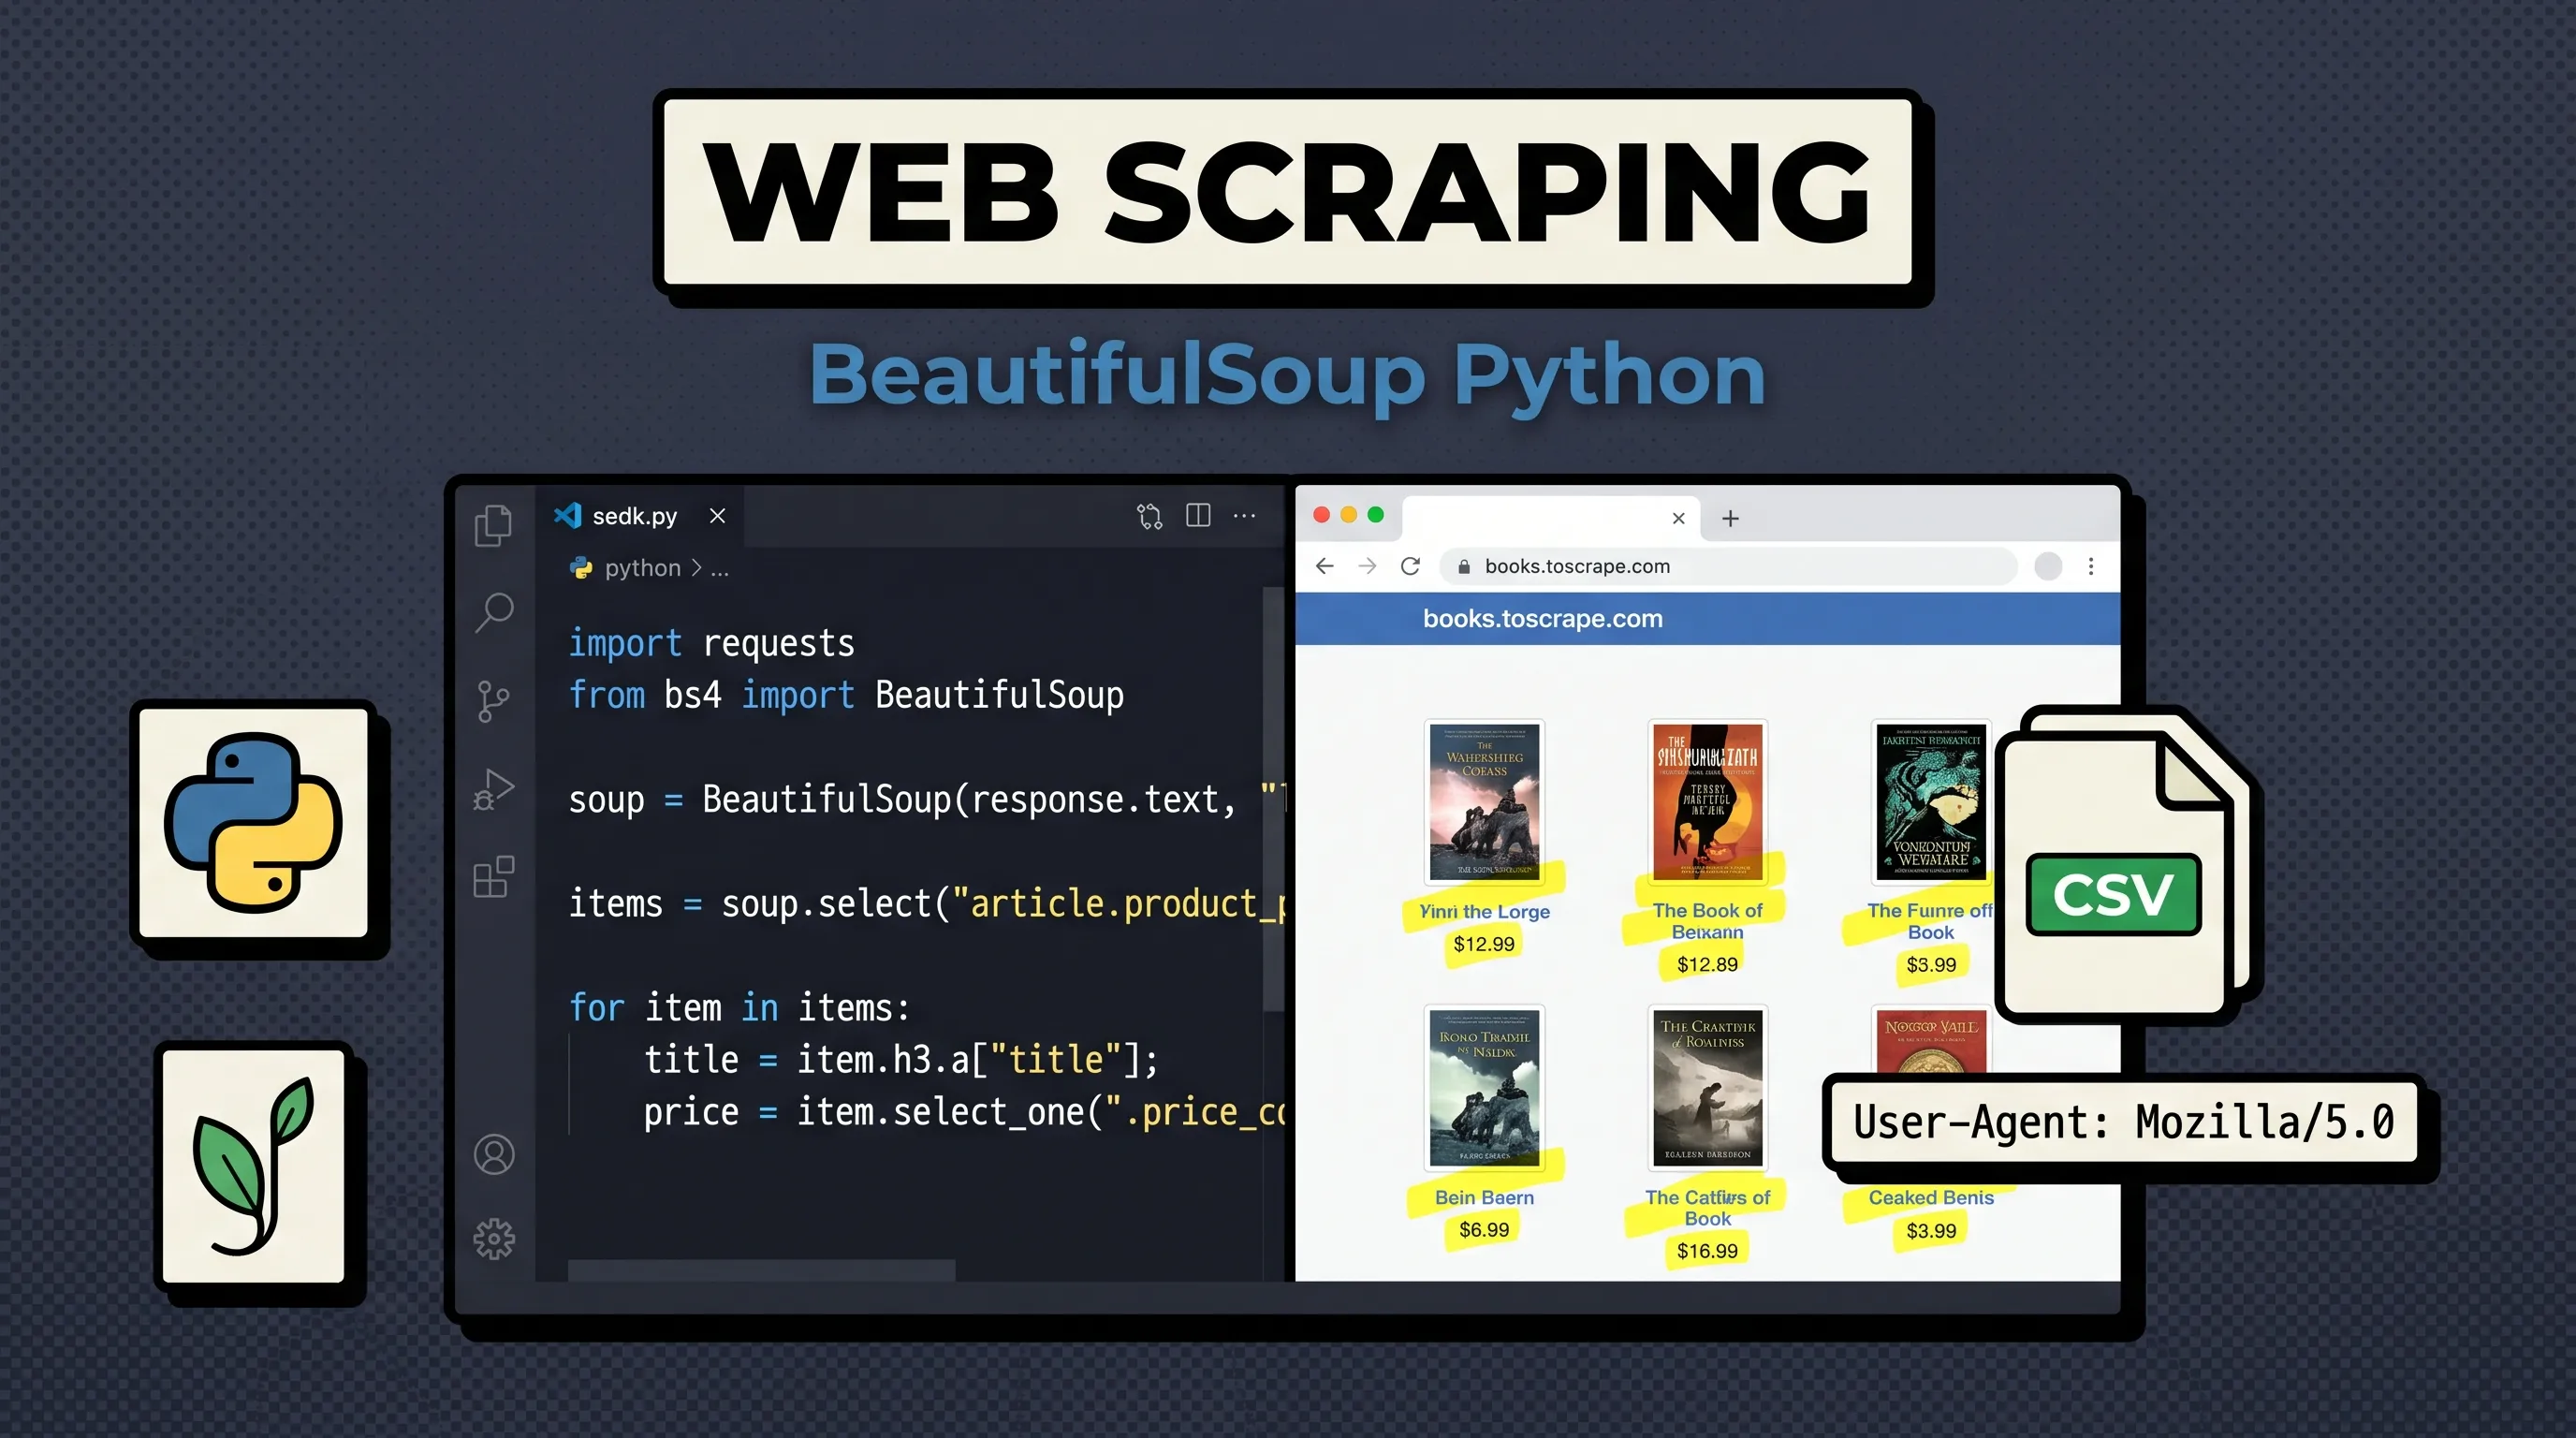
web scraping adalah teknik mengambil data dari halaman web secara otomatis. untuk install library python dengan benar, pastikan sudah paham dulu.
saya pertama kali belajar web scraping karena malas menyalin data dari puluhan halaman web secara manual, dan dalam beberapa jam, satu script Python berhasil melakukan apa yang tadinya butuh seharian. sejak itu, scraping menjadi alat andalan untuk riset dan pengumpulan data. satu hal yang perlu diingat sejak awal: selalu hormati robots.txt dan persyaratan layanan situs yang di-scrape.
1. kapan pakai web scraping?
web scraping cocok dipakai saat:
- data tidak tersedia via API. banyak website kecil belum punya API publik.
- riset kompetitor. pantau harga produk, judul artikel, atau perubahan strategi.
- agregasi data. gabungkan data dari banyak sumber jadi satu dashboard.
- monitoring perubahan. deteksi kapan halaman web berubah (misal harga, lowongan kerja).
- riset dan jurnalisme. kumpulkan data untuk analisis statistik atau investigasi.
jangan dipakai saat:
- website menyediakan API resmi (lebih mudah dan reliable).
- data yang di-scrape bersifat pribadi atau sensitif.
- website melarang scraping di ToS mereka.
- untuk spamming atau tujuan jahat.
2. instalasi library
tiga library yang dibutuhkan:
pip install beautifulsoup4 requests lxml
penjelasan per package:
beautifulsoup4: library untuk parsing HTML dan XML. import denganfrom bs4 import BeautifulSoup.requests: HTTP client untuk download halaman web. lebih simpel dari urllib bawaan.lxml: parser HTML yang lebih cepat dari bawaan Python (html.parser). opsional, tapi direkomendasikan.
kalau belum familiar dengan pip, baca dulu .
verifikasi install:
import requests
from bs4 import BeautifulSoup
print(requests.__version__)  # 2.x.x
print(BeautifulSoup.__version__)  # 4.x.x
3. request halaman pertama
import requests
from bs4 import BeautifulSoup

url = "https://example.com"
response = requests.get(url)
soup = BeautifulSoup(response.text, "html.parser")
penjelasan per baris:
requests.get(url): kirim HTTP GET ke URL, return objek Response. default tanpa timeout sama sekali (None), jadi kalau server hang kode akan nunggu selamanya — wajib set timeout eksplisit.response.text: ambil body response sebagai string (HTML).BeautifulSoup(html, "html.parser"): parse string HTML jadi objek yang bisa di-query. parser default Python, cukup untuk HTML sederhana, tapi lebih baik sebutkan eksplisit biar tidak tergantung ranking parser otomatis.
tambahan best practice:
import requests
from bs4 import BeautifulSoup

url = "https://example.com"

# Tambahkan timeout dan User-Agent
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Bot/1.0"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()  # Raise error kalau 4xx/5xx
    soup = BeautifulSoup(response.text, "lxml")  # pakai lxml lebih cepat
except requests.exceptions.RequestException as e:
    print(f"Error: {e}")
penjelasan per baris:
import requests: import library requests untuk HTTP request.from bs4 import BeautifulSoup: import class BeautifulSoup dari package bs4.url = "...": simpan URL di variabel biar gampang diubah-ubah.headers = {...}: dictionary berisi HTTP headers.User-Agentmemberitahu server browser/OS yang dipakai. tanpa ini, beberapa website kasih 403 Forbidden.try:: buka blok try untuk handle error.response = requests.get(url, headers=headers, timeout=10): kirim GET request.timeout=10artinya maksimal tunggu 10 detik, kalau lebih akan Timeout exception.response.raise_for_status(): cek status code. kalau 4xx (client error) atau 5xx (server error), otomatis raise HTTPError exception.soup = BeautifulSoup(response.text, "lxml"): parse HTML jadi objek yang bisa di-query. parser"lxml"lebih cepat dari"html.parser", perlu install paketlxml.except requests.exceptions.RequestException as e:: tangkap semua error dari requests (timeout, connection, HTTP). cetak pesannya.- kalau error,
souptidak terdefinisi. tambahreturndi akhir except atau gunakan else clause kalau mau robust.
4. mencari elemen di HTML
ada dua cara utama: method chaining BeautifulSoup atau CSS selector.
dengan find() dan find_all()
# Cari tag pertama
title = soup.find("title")
print(title.text)  # 'Example Domain'

# Cari semua tag tertentu
links = soup.find_all("a")
for link in links:
    print(link.get("href"))

# Cari dengan class
items = soup.find_all("div", class_="item")

# Cari dengan id
header = soup.find(id="header")

# Nested search
article = soup.find("article")
title = article.find("h2")
penjelasan per baris:
soup.find("title"): cari tag<title>pertama. return Tag atau None kalau tidak ketemu.title.text: ambil teks di dalam tag. kalau title =<title>Example Domain</title>, hasilnya string"Example Domain".soup.find_all("a"): cari semua tag<a>(link) di dokumen. return list Tag.for link in links:: loop untuk proses setiap link.link.get("href"): ambil nilai atributhrefdari tag. return string URL atau None.soup.find_all("div", class_="item"): cari semua<div class="item">.class_pakai underscore karenaclassadalah keyword Python.soup.find(id="header"): cari tag dengan atributid="header". cara pintas untuk tag unik.article = soup.find("article"): cari tag article.article.find("h2"): nested search: cari<h2>di dalam article yang sudah ketemu. ini pattern umum untuk scrape list item.
penjelasan per method:
find(tag, attrs): cari tag pertama yang cocok, return satu elemen atauNone.find_all(tag, attrs): cari semua tag yang cocok, return list. bisa return list kosong.class_pakai underscore karenaclassreserved di Python.- cari nested: panggil
find()lagi di hasilfind().
dengan CSS selector
# sama dengan find_all("div", class_="item")
items = soup.select("div.item")

# nested selector
links = soup.select("article a.link")

# by id
header = soup.select_one("#header")

# by attribute
images = soup.select("img[src]")
penjelasan per baris:
soup.select("div.item"): CSS selector: semua tag<div>dengan classitem. equivalent denganfind_all("div", class_="item").soup.select("article a.link"): selector bersarang: semua<a class="link">di dalam<article>. spasi artinya descendant (anak/cucu).soup.select_one("#header"): ambil satu tag dengan id=“header” (#= id). return satu Tag atau None, bukan list.soup.select("img[src]"): semua<img>yang punya atributsrc. bracket[]artinya filter by atribut.
aturan praktis:
- find/find_all untuk struktur HTML sederhana, method chaining enak dibaca.
- select untuk selector kompleks, atau kalau kalian sudah hapal CSS selector.
5. ekstrak teks dan atribut
for item in items:
    judul = item.find("h2").text.strip()
    harga = item.find("span", class_="harga").text
    link = item.find("a").get("href")
    image = item.find("img").get("src")  # atau ['src']
    print(f"{judul}: {harga} ({link})")
penjelasan per method:
.text: ambil teks dalam tag, return string. termasuk teks dari child element..get("href"): ambil nilai atribut. returnNonekalau atribut tidak ada, lebih aman dari["href"]yang error..get("src", default): bisa kasih default value kalau atribut tidak ada..strip(): hapus whitespace di awal/akhir string. berguna untuk data yang ada newline atau spasi.["href"]: alternatif, tapi raise KeyError kalau tidak ada.
6. navigasi tree HTML
BeautifulSoup bisa navigasi tree ke parent, child, sibling:
# Parent
h2 = soup.find("h2")
parent_div = h2.parent

# Children langsung (tag saja, exclude string)
div = soup.find("div")
for child in div.children:
    print(child.name)  # nama tag

# Sibling
h2 = soup.find("h2")
next_sib = h2.find_next_sibling()
prev_sib = h2.find_previous_sibling()
penjelasan per baris:
h2 = soup.find("h2"): ambil tag h2 pertama.h2.parent: naik ke parent element. kalau h2 ada di dalam div,parentadalah div itu.div = soup.find("div"): ambil div pertama.for child in div.children:: loop semua anak langsung dari div.childrenreturn iterator berisi Tag dan NavigableString (whitespace).child.name: nama tag kalau child adalah Tag, None kalau NavigableString.h2.find_next_sibling(): cari sibling berikutnya (tag di level yang sama, setelah h2). return Tag atau None.h2.find_previous_sibling(): cari sibling sebelumnya. return Tag atau None.
berguna untuk struktur HTML yang tidak konsisten, atau untuk ekstrak metadata dari parent element.
7. simpan hasil ke CSV
import csv

data = []
for item in items:
    judul = item.find("h2").text.strip()
    harga = item.find("span", class_="harga").text
    link = item.find("a").get("href")
    data.append([judul, harga, link])

with open("hasil.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Judul", "Harga", "Link"])  # header
    writer.writerows(data)  # data
penjelasan per baris:
import csv: import module csv bawaan Python.data = []: list kosong untuk kumpulkan baris.for item in items:: loop untuk setiap item (misal produk).judul = item.find("h2").text.strip(): ambil teks h2,.strip()hapus whitespace di awal/akhir.harga = item.find("span", class_="harga").text: ambil teks span dengan class “harga”.link = item.find("a").get("href"): ambil URL dari atribut href.data.append([judul, harga, link]): tambahkan baris [judul, harga, link] ke list.with open("hasil.csv", "w", ...) as f:: buka file untuk write.newline=""agar tidak ada baris kosong antar baris di Windows.encoding="utf-8": biar karakter Indonesia/emoji tidak rusak.writer = csv.writer(f): buat CSV writer.writer.writerow([...]): tulis satu baris (header).writer.writerows(data): tulis banyak baris dari list data.
untuk data banyak dan perlu analisis, simpan ke Pandas DataFrame:
import pandas as pd

df = pd.DataFrame(data, columns=["Judul", "Harga", "Link"])
df.to_csv("hasil.csv", index=False)
# atau langsung ke Excel
df.to_excel("hasil.xlsx", index=False)
penjelasan per baris:
import pandas as pd: import library pandas dengan alias pd.df = pd.DataFrame(data, columns=[...]): buat DataFrame dari list data, dengan nama kolom eksplisit.df.to_csv("hasil.csv", index=False): simpan ke CSV.index=Falsesupaya index (0,1,2,…) tidak ikut jadi kolom.df.to_excel("hasil.xlsx", index=False): simpan ke Excel. perlu install libraryopenpyxl.
detail baca/tulis CSV dengan Pandas bisa baca di tutorial (09/18 publish).
8. handle pagination
scraping multi-halaman pakai loop:
import requests, csv, time
from bs4 import BeautifulSoup

base_url = "https://news.example.com/page/{}"
all_news = []

for page in range(1, 6):  # page 1 sampai 5
    url = base_url.format(page)
    print(f"Scraping {url}...")

    try:
        response = requests.get(url, headers={"User-Agent": "Mozilla/5.0"}, timeout=10)
        response.raise_for_status()
        soup = BeautifulSoup(response.text, "lxml")

        articles = soup.find_all("article")
        for article in articles:
            title = article.find("h2").text.strip()
            link = article.find("a").get("href")
            date = article.find("time").text.strip() if article.find("time") else ""
            all_news.append([title, link, date])

        print(f"  → {len(articles)} artikel")
        time.sleep(1)  # jeda 1 detik, jangan terlalu cepat

    except requests.exceptions.RequestException as e:
        print(f"  → Error: {e}")
        continue  # lanjut ke page berikutnya

# Simpan ke CSV
with open("berita.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Judul", "Link", "Tanggal"])
    writer.writerows(all_news)

print(f"\nSelesai! {len(all_news)} artikel disimpan ke berita.csv")
penjelasan per baris:
import requests, csv, time: import 3 module sekaligus dalam satu baris.from bs4 import BeautifulSoup: import BeautifulSoup.base_url = ".../page/{}": template URL dengan{}sebagai placeholder untuk nomor halaman.all_news = []: list untuk kumpulkan semua artikel dari semua halaman.for page in range(1, 6):: loop page 1 sampai 5 (range stop eksklusif, jadi 5 tidak ikut).url = base_url.format(page): ganti{}dengan nomor halaman. contoh:.../page/1,.../page/2, dst.print(f"Scraping {url}..."): log progress, biar keliatan lagi di page mana.try:: buka blok try untuk handle error per halaman.response = requests.get(url, headers=..., timeout=10): request dengan User-Agent dan timeout 10 detik.response.raise_for_status(): raise error kalau status code 4xx/5xx.soup = BeautifulSoup(response.text, "lxml"): parse HTML dengan lxml.articles = soup.find_all("article"): cari semua tag article.for article in articles:: loop untuk setiap article.title = article.find("h2").text.strip(): ambil judul.link = article.find("a").get("href"): ambil URL.date = article.find("time").text.strip() if article.find("time") else "": ternary: ambil tanggal kalau ada tag time, kalau tidak string kosong.all_news.append([title, link, date]): tambahkan baris ke list.print(f" → {len(articles)} artikel"): log jumlah artikel per halaman.time.sleep(1): jeda 1 detik. penting supaya tidak kena rate limit.except requests.exceptions.RequestException as e:: tangkap semua error request.continue: skip sisa loop, lanjut ke page berikutnya (tidak stop total).with open("berita.csv", "w", ...): buka file CSV untuk write.writer.writerow([...]): tulis header.writer.writerows(all_news): tulis semua data.
time.sleep(1) itu penting. tanpa jeda, server bisa anggap request anda sebagai serangan DDoS dan block IP anda.
9. error handling yang robust
scraper production harus handle error dengan baik:
def scrape_url(url, retries=3):
    """Scrape URL dengan retry otomatis."""
    for attempt in range(1, retries + 1):
        try:
            response = requests.get(
                url,
                headers={"User-Agent": "Mozilla/5.0"},
                timeout=10
            )
            response.raise_for_status()
            return BeautifulSoup(response.text, "lxml")
        except requests.exceptions.Timeout:
            print(f"  Timeout, retry {attempt}/{retries}...")
        except requests.exceptions.HTTPError as e:
            print(f"  HTTP error: {e}")
            return None  # jangan retry kalau 4xx
        except requests.exceptions.RequestException as e:
            print(f"  Error: {e}")
            time.sleep(2 ** attempt)  # exponential backoff
    return None
penjelasan per baris:
def scrape_url(url, retries=3):: definisi fungsi dengan parameterurl(wajib) danretries=3(default 3 kali coba)."""Scrape URL dengan retry otomatis.""": docstring, penjelasan fungsi.for attempt in range(1, retries + 1):: loop sebanyak retries.+1karena range stop eksklusif.try:: buka blok try.response = requests.get(url, headers=..., timeout=10): request ke URL.response.raise_for_status(): cek status code, raise HTTPError kalau 4xx/5xx.return BeautifulSoup(...): kalau sukses, return soup langsung (fungsi selesai).except requests.exceptions.Timeout:: tangkap error timeout (server lambat/tidak respon).print(f" Timeout, retry {attempt}/{retries}..."): log retry attempt. f-string untuk format.except requests.exceptions.HTTPError as e:: tangkap HTTP 4xx/5xx.as esupaya bisa akses pesan error.return None: langsung return, jangan retry. 4xx biasanya permanen (URL salah, halaman dihapus).except requests.exceptions.RequestException as e:: tangkap error lain (connection error, SSL error, dll).time.sleep(2 ** attempt): exponential backoff. attempt 1: 2s, attempt 2: 4s, attempt 3: 8s.return None: di luar loop, return None kalau semua retry gagal.
prinsip-prinsipnya:
- retry untuk error sementara (timeout, 5xx).
- jangan retry untuk 4xx (client error, biasanya permanen).
- exponential backoff (1s, 2s, 4s, …) untuk hindari overload server.
- log error untuk debug nanti.
10. etika dan legalitas scraping
yang harus dilakukan:
- cek
robots.txtdihttps://example.com/robots.txtsebelum scrape. - tambah jeda antar request (minimal 1 detik).
- set User-Agent yang jelas (jangan pura-pura jadi browser kalau anda bot).
- cache hasil : kalau data tidak berubah, simpan ke file lokal, jangan scrape ulang.
- hormati copyright : data yang di-scrape tetap milik pemilik website.
- hubungi pemilik untuk data skala besar atau komersial.
yang harus dihindari:
- scrape data pribadi atau sensitif.
- bypass login atau paywall tanpa izin.
- scrape ribuan halaman per menit (overload server).
- abaikan ToS website yang melarang scraping.
- komersialkan data yang dilindungi copyright.
konsekuensi melanggar: IP block, tuntutan hukum, atau banned permanen.
11. alternatif web scraping
selain BeautifulSoup, ada beberapa tools lain yang umum dipakai:
| Tool | Kapan Dipakai |
|---|---|
| BeautifulSoup + requests | proyek kecil-menengah, belajar, scraping statis |
| Scrapy | proyek besar, butuh async, pipeline otomatis |
| Selenium/Playwright | website dengan JavaScript rendering, butuh interaksi (klik, login) |
| API | kalau website menyediakan API resmi (selalu pilih ini dulu) |
| RSS | blog atau berita yang punya feed RSS |
| requests-html | JavaScript rendering ringan dengan syntax mirip requests |
pilih berdasarkan kompleksitas target:
- HTML statis → BeautifulSoup.
- JavaScript-rendered → Selenium/Playwright.
- API resmi → requests langsung ke endpoint API.
12. contoh lengkap: scrape daftar buku
import requests
from bs4 import BeautifulSoup
import csv
import time

url = "https://books.toscrape.com/"
headers = {"User-Agent": "Mozilla/5.0"}
response = requests.get(url, headers=headers, timeout=10)
soup = BeautifulSoup(response.text, "lxml")

books = []
items = soup.select("article.product_pod")

for item in items:
    title = item.h3.a["title"]  # ambil atribut title
    price = item.select_one(".price_color").text
    rating = item.p["class"][1]  # "Three", "Four", dll
    link = item.h3.a["href"]

    books.append({
        "title": title,
        "price": price,
        "rating": rating,
        "link": "https://books.toscrape.com/" + link
    })

# Simpan ke CSV
with open("books.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price", "rating", "link"])
    writer.writeheader()
    writer.writerows(books)

print(f"{len(books)} buku disimpan ke books.csv")
penjelasan per baris:
import requestsdanfrom bs4 import BeautifulSoup: library utama.import csv, time: module CSV untuk write file, time untuk jeda (meskipun di contoh ini tidak dipakai).url = "https://books.toscrape.com/": URL target. books.toscrape.com adalah website练习 scraping legal.headers = {"User-Agent": "Mozilla/5.0"}: set User-Agent supaya tidak di-block.response = requests.get(url, headers=headers, timeout=10): request dengan timeout 10 detik.soup = BeautifulSoup(response.text, "lxml"): parse dengan lxml (lebih cepat).books = []: list kosong untuk kumpulkan dict per buku.items = soup.select("article.product_pod"): CSS selector untuk ambil semua tag<article class="product_pod">.for item in items:: loop untuk setiap buku.title = item.h3.a["title"]: navigasi bertingkat: dari article ke h3 ke a, ambil atribut title. shorthand untukitem.find("h3").find("a")["title"].price = item.select_one(".price_color").text: CSS selector untuk class price_color, ambil teks.rating = item.p["class"][1]: ambil class list dari tag p, indeks [1] adalah rating (“Three”, “Four”, “Five”, dll). indeks [0] biasanya “star-rating”.link = item.h3.a["href"]: ambil URL relatif dari atribut href.books.append({...}): tambahkan dict (4 field) ke list."link": "https://books.toscrape.com/" + link: gabung URL absolut (domain + path relatif).with open("books.csv", "w", ...): buka file CSV untuk write.writer = csv.DictWriter(f, fieldnames=[...]): DictWriter untuk write list of dict, perlu deklarasi nama field.writer.writeheader(): tulis baris header.writer.writerows(books): tulis semua baris data.print(f"{len(books)} buku..."): cetak jumlah buku yang dikumpulkan.
books.toscrape.com adalah website scraping yang legal (dirancang untuk). output CSV bisa dianalisis pakai Pandas atau Excel.
Kesimpulan
- requests untuk ambil HTML, BeautifulSoup untuk parse dan query
find()untuk satu elemen,find_all()untuk semua,select()untuk CSS selector.textuntuk teks,.get("attr")untuk atribut (lebih aman dari["attr"])- selalu set User-Agent dan timeout di requests
- gunakan time.sleep() antar request supaya tidak dianggap spam
- cek robots.txt sebelum scrape website baru
- untuk data banyak, simpan ke CSV/Excel/SQLite atau langsung ke Pandas DataFrame
- untuk JavaScript-rendered website, pakai Selenium/Playwright, bukan BeautifulSoup
Baca Juga Mengenai :
Pertanyaan yang Sering Diajukan
Apa itu web scraping dan kapan dipakai?
web scraping adalah teknik mengambil data dari halaman web secara otomatis. dipakai saat data tidak tersedia via API, atau untuk riset kompetitor, agregasi harga, monitoring perubahan halaman, dan pengumpulan data riset.
Apakah web scraping legal?
tergantung. scraping data publik biasanya oke, tapi hormati robots.txt, ToS website, dan jangan scrape data pribadi atau konten berbayar. untuk data sensitif, lebih baik pakai API resmi.
Bedanya BeautifulSoup dengan library scraping lain seperti Scrapy?
BeautifulSoup ringan, cocok untuk scraping sederhana sampai menengah. Scrapy framework lengkap untuk proyek besar dengan fitur async, pipeline, dan auto-throttle. pakai BeautifulSoup untuk belajar atau proyek kecil, Scrapy untuk skala besar.
Bagaimana cara install BeautifulSoup?
pip install beautifulsoup4 requests lxml. beautifulsoup4 adalah nama package-nya, sedangkan import pakai from bs4 import BeautifulSoup.
Kenapa hasil scraping dapat error 403 Forbidden?
beberapa website block request tanpa User-Agent yang valid. tambahkan headers={"User-Agent": "Mozilla/5.0"} di requests.get(). website lain mungkin butuh cookie atau login.
Bagaimana cara scrape banyak halaman sekaligus?
pakai loop dengan range untuk pagination. contoh: for page in range(1, 11): url = base_url.format(page). tambahkan time.sleep() antar request supaya tidak dianggap spam.
Apa bedanya find() dan select() di BeautifulSoup?
find() pakai method chaining BeautifulSoup, misal find("div", class_="item"). select() pakai CSS selector seperti "div.item" atau "#header > a". pilih sesuai kebutuhan dan kebiasaan.
Bagaimana cara simpan hasil scraping?
paling umum ke CSV pakai module csv bawaan Python. untuk data banyak atau perlu query, simpan ke SQLite atau Pandas DataFrame. untuk analisis lebih lanjut, export ke JSON atau Excel.
Kenapa scraper tiba-tiba berhenti setelah beberapa request?
kemungkinan besar kena rate limit atau IP block. tambah time.sleep() yang lebih lama, ganti User-Agent, atau pakai proxy. beberapa website juga detect pola request terlalu cepat.